MCP-RagDoc ทำงานอย่างไร — Document RAG ที่รักษา source truth
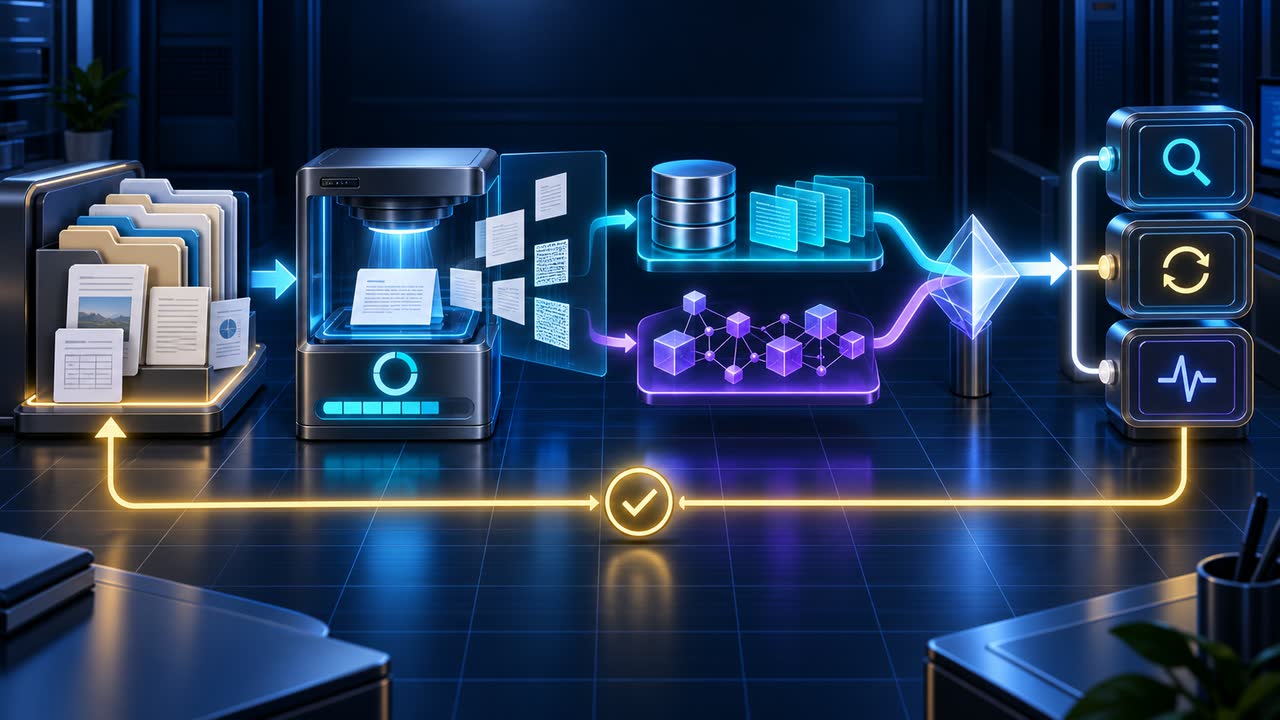
MCP-RagDoc ถูกออกแบบให้เป็น document knowledge library มากกว่า chat assistant หน้าที่ของมันคือเปลี่ยนชุดเอกสารจริงให้เป็น index ที่ค้นได้ และคืนหลักฐานพร้อม provenance ให้ agent อื่นนำไปใช้ต่อ
Architecture โดยย่อ
nested source documents
        │
        ▼
 extraction / OCR
        │
        ├─ SQLite lexical index (FTS5/BM25)
        └─ optional semantic generation (MiniLM ONNX INT8)
                         │
                         ▼
                      RRF fusion
                         │
                         ▼
              source path + location
                         │
               MCP / local HTML UI
1. Recursive source discovery แต่ scope คงที่
MCP-RagDoc index เอกสารใต้ configured knowledge directory และ visible nested directories
แต่ scope นี้ถูกกำหนดตอน process launch ไม่ใช่จาก MCP tool argument จึงไม่มี query ไหนที่สามารถสั่งให้ backend “ลองค้น Desktop ทั้งหมด” ได้เอง
hidden paths, symlinks และ sensitive-looking paths ถูกข้าม/ปฏิเสธตาม policy
2. Extraction แยกตามชนิดเอกสาร
pipeline รองรับหลาย source types แต่ไม่บังคับให้ทุกอย่างผ่าน parser เดียว:
- PDF ใช้ text layer เมื่อมี
- scanned PDF rasterize ทีละ physical page แล้ว OCR
- DOC/DOCX, XLS/XLSX, PPT/PPTX และ ODF ใช้ extractor ที่เหมาะกับ format
- image files ใช้ OCR path
- text-like files stream เป็น chunks โดยไม่ materialize เอกสารใหญ่ทั้งก้อนเกินจำเป็น
แนวคิดคือ preserve location เท่าที่ source format ให้ได้ เช่นหน้า PDF หรือ unit ในเอกสาร เพื่อให้ result ชี้กลับไปยังต้นฉบับได้
3. OCR เริ่มจาก Apple Vision
สำหรับหน้าสแกน Apple Vision OCR เป็น baseline เพราะเป็น on-device deterministic sensor บน macOS
MCP-RagDoc มี optional OCR rewrite path ที่ส่ง:
300-DPI page image + original OCR textไปยัง local OpenAI-compatible vision model ทีละหน้า เพื่อแก้คำที่ OCR อ่านผิดแบบ conservative
rewrite ใหม่ต้องผ่าน validation ก่อน หาก model unavailable, response ใช้ไม่ได้ หรือ validation fail ระบบเก็บ original OCR แทน
จึงไม่เกิด failure mode แบบ “LLM ช่วยไม่ได้ เลยไม่มีข้อความให้ index”
4. SQLite lexical index เป็นฐานที่ใช้ได้เสมอ
Search base ใช้ SQLite FTS5 trigram + BM25 แล้วเสริม logic สำหรับเอกสารจริง เช่น:
- filename-first lookup
- Thai/mixed word segmentation
- aliases/synonyms บางชุด
- English split-word recovery จาก PDF/OCR
- bounded OCR fuzzy recovery
- filesystem-truth/path validation
เส้นทางนี้ไม่ต้องใช้ semantic model
5. Semantic retrieval เป็น optional generation
ถ้า operator เปิด semantic retrieval ระบบใช้ multilingual MiniLM ผ่าน ONNX INT8 worker
semantic children ถูกแบ่งด้วย word-boundary-aware chunking และเก็บ vector แบบ normalized float16 สำหรับ exact cosine search
worker เป็น short-lived subprocess: ML runtime ไม่ค้าง resident ใน MCP server หลังงาน build/query จบ
6. Semantic generation publish แบบ fail-safe
semantic state มี generation lifecycle ของตัวเอง generation ใหม่จะ publish ready=1 ก็ต่อเมื่อ build เสร็จสมบูรณ์
ถ้า cancel หรือ fail กลางทาง generation ที่ไม่ครบจะไม่ถูกประกาศพร้อมใช้ ทำให้ search ไม่สลับไปใช้ vector set ครึ่งชุด
model/policy fingerprint ยังช่วยกันการเอา vector ที่สร้างด้วย policy/model คนละชุดมาปะปนกัน
7. RRF รวม lexical กับ semantic
เมื่อ semantic พร้อม ระบบไม่เอา raw BM25 score ไปเทียบ cosine ตรงๆ แต่รวม ranking ด้วย Reciprocal Rank Fusion
lexical rank ─┐
              ├─ RRF → fused results
semantic rank ┘
วิธีนี้ deterministic และไม่ต้องมี LLM reranker
8. Sync เป็น persistent background job
sync_kb() คืน job_id ทันที Detached worker ทำ incremental refresh และ persist job state ใต้ private data directory
progress ครอบคลุมทั้ง lexical phases และ semantic parent progress ช่วงท้าย ผู้ใช้จึงเห็น current file, completed/total, percentage และ ETA
9. Cancellation รักษา transaction integrity
การ cancel เป็น cooperative:
- เช็คก่อนเริ่มไฟล์และระหว่าง chunk generation
- in-progress document transaction rollback เมื่อหยุด
- already committed documents ยังคง valid
- incomplete semantic generation ไม่ publish ready
เป้าหมายไม่ใช่ “หยุดทันทีทุก instruction” แต่คือหยุดเร็วพอโดยไม่ทิ้ง index อยู่ใน state ที่เชื่อถือไม่ได้
10. Provenance เป็น output contract
ผลค้นไม่ได้มีเพียง snippet แต่เก็บ path/location ของ source ที่ตรวจได้
ใน UI indexed-file list ยังแสดง relative path, absolute path, type, size และ chunk count; search result เก็บ source absolute path/page เพื่อเปิดไฟล์ต้นฉบับต่อได้
นี่คือแกนของ trust of source: answer ที่ agent สร้างอาจผิดได้ แต่ผู้ใช้ยังมีเส้นทางกลับไปตรวจเอกสารจริง
11. Standalone ไม่ได้แปลว่าผูกกับ Agent Lite
MCP-RagDoc มี config, server, service, sync worker, search, semantic worker และ UI ของตัวเอง Host-specific routing/retry/turn guards อยู่ฝั่ง consuming agent
ดังนั้น Agent Lite เป็นเพียงหนึ่ง client ของ MCP-RagDoc ไม่ใช่ owner ของ backend architecture
ความคิดเห็น
กำลังโหลดความคิดเห็น...