เริ่มต้นใช้งาน MCP-RagDoc
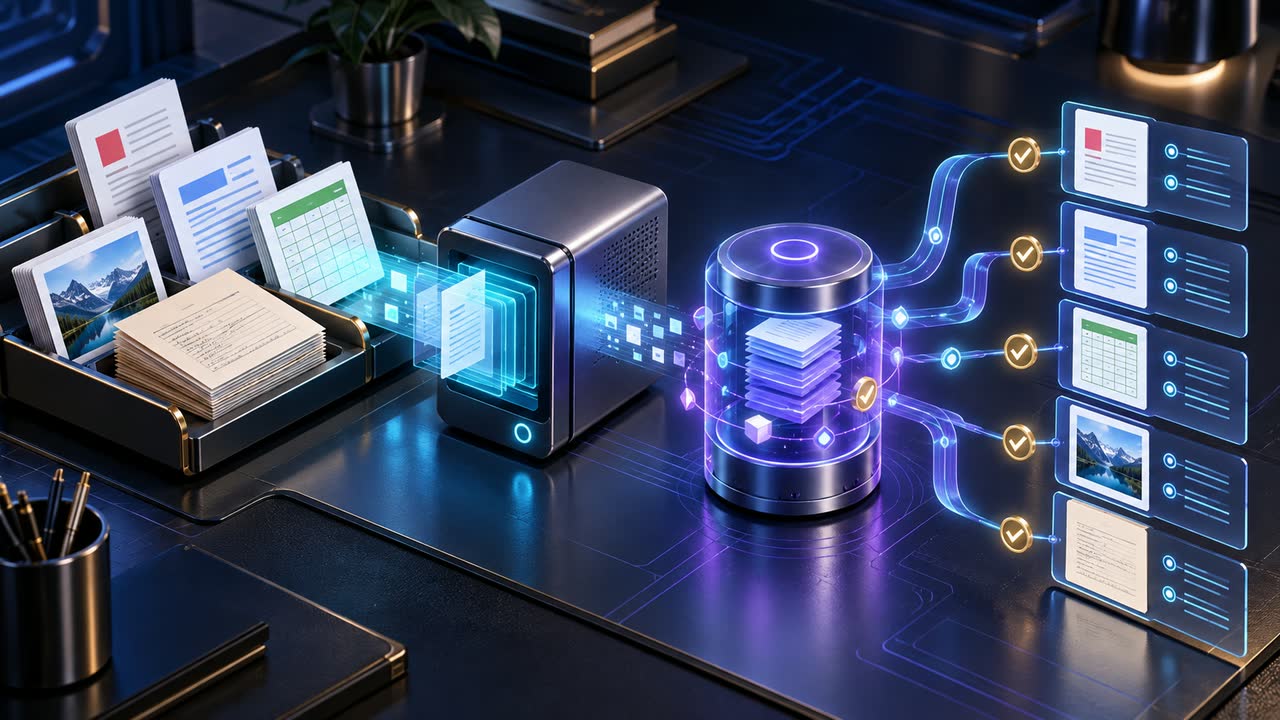
MCP-RagDoc คือ document RAG MCP server แบบ agent-agnostic สำหรับทำคลังเอกสารในเครื่อง โดยเน้นสองเรื่องพร้อมกัน: ค้นได้ดี และย้อนกลับไปตรวจ source of truth ได้ว่า snippet มาจากไฟล์/หน้าไหน
มันไม่ได้เป็น chat agent และไม่ผูกกับ Agent Lite แม้ Agent Lite จะใช้ MCP-RagDoc เป็น Knowledge Base backend อยู่ก็ตาม
เหมาะกับงานแบบไหน
- คลัง PDF, Word, Excel, PowerPoint และเอกสาร Office อื่น
- PDF สแกนหรือภาพเอกสารที่ต้อง OCR
- คลังข้อมูลที่ต้องค้นทั้งชื่อไฟล์, keyword และความหมาย
- ระบบที่ต้องคืน absolute source path กับ page/location ให้ caller เปิดต้นฉบับต่อได้
- agent host หลายแบบที่อยากใช้ RAG backend เดียวกันผ่าน MCP stdio
MCP 5 tools
| Tool | หน้าที่ |
|---|---|
rag_search(query) |
ค้น filename + FTS5/BM25 + OCR fuzzy + optional semantic แล้ว fuse ด้วย RRF |
sync_kb() |
เริ่ม incremental background sync และคืน persistent job_id |
sync_status(job_id) |
ดู phase, percentage, current file, completed/total, ETA และ semantic progress |
cancel_sync(job_id) |
ขอ cooperative cancellation ที่ safe checkpoints |
rag_health() |
ตรวจ source/index/semantic readiness โดยไม่ต้องอ่าน full document bodies |
Source กับ state แยกจากกัน
Standalone defaults:
source documents: rag_document/
private state:    ~/.mcp-ragdoc/
Source documents เป็น read-only ต่อ MCP-RagDoc ส่วน SQLite/index/jobs เขียนใน private state ที่ operator กำหนด
หนึ่ง server process ถูก scope กับ source directory หนึ่งชุดตลอดอายุ process เครื่องมือ MCP ไม่มี argument สำหรับขยาย source root ไปที่อื่นตามใจ caller
รองรับเอกสารอะไรบ้าง
- text / Markdown / CSV / JSON / YAML-style text
- DOC / DOCX
- XLS / XLSX
- PPT / PPTX
- ODF documents
- common image formats
source ใต้ nested directories ถูก index แบบ recursive โดยข้าม hidden, symlinked และ sensitive-looking paths
ติดตั้ง
git clone https://github.com/halochamp/MCP-RagDoc.git
cd MCP-RagDoc
python3.11 -m venv .venv
.venv/bin/python -m pip install --upgrade pip
.venv/bin/python -m pip install -r requirements.txt
bash scripts/build_vision_ocr.sh
บน macOS Apple Silicon สคริปต์สุดท้าย build Apple Vision OCR helper จาก Swift source ใน repo
เปิด MCP server
.venv/bin/python rag_server.py \
  --knowledge-dir "$PWD/rag_document" \
  --data-dir "$HOME/.mcp-ragdoc"
หรือ MCP host เปิด command นี้เป็น local stdio child process
สามารถกำหนด database โดยตรงด้วย --db และเลือก semantic ด้วย --semantic on|off
Sync Knowledge Base
เรียก sync_kb() แล้วจะได้ job_id ทันที งาน sync ทำใน detached worker และ persist state ใต้ DATA_DIR/sync_jobs/
จากนั้น:
sync_status(job_id)จนได้ terminal state หรือใช้:
cancel_sync(job_id)เมื่อผู้ใช้ต้องการหยุด
Search pipeline
ฐานที่ใช้ได้เสมอคือ lexical/OCR retrieval:
filename-first lookup
→ SQLite FTS5 trigram + BM25
→ exact/all-term ranking
→ Thai/mixed segmentation + aliases
→ English split-word recovery
→ OCR fuzzy recovery
→ filesystem truth/path validation
ถ้ามี semantic index พร้อม ระบบเพิ่ม MiniLM semantic ranks แล้วรวมผลด้วย deterministic RRF
Optional semantic retrieval
ใช้ sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2 ผ่าน ARM64 ONNX INT8 worker แบบ short-lived process
จุดสำคัญคือ search request ไม่ download model เอง MCP-RagDoc จะใช้ snapshot ที่มีใน Hugging Face cache หรือ operator ระบุ --semantic-model-dir
ถ้า semantic ไม่พร้อม ระบบยังค้นด้วย lexical/OCR ได้
เอกสารสแกนและ OCR
สำหรับหน้าที่ไม่มี text layer ระบบใช้ Apple Vision OCR เป็นฐาน และสามารถเลือกส่ง ภาพหน้าเดียว + OCR text เดิม ไปยัง local OpenAI-compatible vision model เพื่อแก้ OCR แบบ conservative ก่อนเขียน SQLite
Standalone public default ไม่ start/stop model process เอง ค่า default endpoint คือ local 127.0.0.1:8090
ถ้า VLM unavailable หรือ validation ไม่ผ่าน ระบบเก็บ OCR เดิม ไม่ทิ้งข้อมูลเพียงเพราะ rewrite ใช้ไม่ได้
Local HTML console
.venv/bin/python main.pyเปิด http://127.0.0.1:8769
หน้า console มี Search / Sync / Progress / Health / indexed files และสามารถเปิด source file ต้นฉบับจาก path ที่ผ่าน knowledge-root validation ได้
Trust of source
MCP-RagDoc ตั้งใจรักษา provenance เป็นส่วนหนึ่งของ retrieval result:
query
  ↓
matching snippet
  ↓
absolute source path + page/location
  ↓
caller เปิด/อ่านต้นฉบับเพื่อตรวจยืนยัน
นี่สำคัญกับงานเอกสารมากกว่าการได้ semantic answer อย่างเดียว เพราะผู้ใช้ยังย้อนกลับไปดู PDF/Word ต้นฉบับที่เป็น source of truth ได้
ความปลอดภัย
- source documents ไม่ถูกแก้โดย
sync_kbหรือrag_search - state writes อยู่ใน private data/db path ที่ operator เลือก
- hidden/symlinked/sensitive/out-of-root paths fail closed
- incomplete semantic generation ไม่ publish
ready=1 - UI bind loopback และ state-changing browser request ตรวจ same-origin
- backend ไม่ import host-agent modules
ความคิดเห็น
กำลังโหลดความคิดเห็น...